Hiểu Big O bằng cách đếm phép so sánh khi tìm liên hệ
Đếm công việc của tìm kiếm tuyến tính, tìm kiếm nhị phân và chỉ mục Map; phân biệt mô hình độ phức tạp với thời gian chạy thực tế.
Nếu đã biết mảng và vòng lặp trong JavaScript, bạn có thể bắt đầu học Big O bằng một hàm tìm liên hệ. Ta đếm được công việc của hàm trước khi cần đến đồng hồ. Giả sử mảng có 1.000 liên hệ và hàm lần lượt so sánh ID cần tìm với ID của từng phần tử. Tìm phần tử đầu tiên cần một phép so sánh. Tìm phần tử cuối cùng cần 1.000 phép. Nếu ID không tồn tại, hàm cũng phải so sánh 1.000 lần.
Cùng một hàm nhưng lượng công việc thay đổi theo dữ liệu đầu vào, bao gồm vị trí của liên hệ cần tìm. Big O mô tả cách một chi phí đã chọn tăng khi kích thước đầu vào lớn hơn. Bản chép lời bài giảng về thuật toán và tính toán của MIT phân biệt kích thước đầu vào với số thao tác thuật toán thực hiện. Với cách tìm tuần tự này, số phép so sánh trong trường hợp xấu nhất tăng tuyến tính theo số liên hệ.
Đếm rõ công việc đang làm
Bạn có thể chạy ví dụ sau trong bảng điều khiển của trình duyệt hoặc Node.js. Trường comparisons chỉ phục vụ việc quan sát. Trong ứng dụng, hàm tìm kiếm thường chỉ cần trả về liên hệ hoặc vị trí của nó.
function findContact(contacts, wantedId) {
  let comparisons = 0;
  for (const contact of contacts) {
    comparisons += 1;
    if (contact.id === wantedId) {
      return { contact, comparisons };
    }
  }
  return { contact: null, comparisons };
}

const contacts = Array.from({ length: 1000 }, (_, id) => ({ id }));
console.log(findContact(contacts, 0).comparisons);    // 1
console.log(findContact(contacts, 999).comparisons);  // 1000
console.log(findContact(contacts, -1).comparisons);   // 1000
Biến kích thước, thường ký hiệu là n, chính là số liên hệ trong mảng. Ta xem mỗi phép kiểm tra ID có chi phí hằng số vì ID là số có kích thước giới hạn. Nếu khóa là chuỗi dài tùy ý, độ dài chuỗi và quy tắc so sánh cũng cần xuất hiện trong mô hình chi phí.
Khi ID không tồn tại, tăng mảng từ 1.000 lên 2.000 phần tử làm số phép so sánh tăng gấp đôi. Nhận xét đó ổn định hơn một kết quả đo thời gian đơn lẻ. Lịch chạy của trình duyệt, trạng thái CPU và tiến trình khác có thể làm thời gian thay đổi mà không làm thuật toán thay đổi.
Trường hợp tốt nhất, xấu nhất và trung bình
Một truy vấn thành công thuận lợi nhất chỉ cần một phép so sánh. Trường hợp xấu nhất cần n phép, dù liên hệ nằm cuối mảng hay hoàn toàn không tồn tại. Muốn nói về trung bình, ta phải xác định truy vấn xuất hiện với xác suất nào.
Nếu mọi ID đang có đều được tìm với xác suất bằng nhau và mọi truy vấn đều thành công, số phép so sánh có thể là một đến n. Giá trị trung bình là (n + 1) / 2. Với 1.000 liên hệ, kết quả là 500,5 phép so sánh. Đây là trung bình của nhiều khả năng; một lần chạy không thực hiện nửa phép so sánh.
Nếu tỷ lệ truy vấn không tìm thấy là p, còn các truy vấn thành công vẫn phân bố đều theo vị trí, số phép so sánh kỳ vọng là (1 - p) * (n + 1) / 2 + p * n. Với p = 0.2 và n = 1000, giá trị đó là 600,4. Nếu người dùng thường tìm các liên hệ ở đầu mảng, trung bình sẽ khác. Cận xấu nhất vẫn giữ nguyên.
Công thức kỳ vọng được suy ra từ các xác suất giả định. Trung bình đo được lại đến từ một tập truy vấn đã chạy. Cả hai đều không tự động mô tả hành vi người dùng của ứng dụng khác. Với mảng rỗng, hàm thực hiện không phép so sánh nào và trả về không có liên hệ; vòng lặp xử lý trường hợp này mà không cần đọc phần tử đầu tiên.
O(n) khẳng định điều gì
Cận trên O(n) nói rằng khi đầu vào đủ lớn, chi phí không vượt quá một hằng số nhân với n. Phát biểu chính xác là tồn tại các hằng số dương c và n₀ sao cho chi phí không lớn hơn c × n với mọi n ≥ n₀.
Cách mô tả này bỏ qua chi phí khởi động cố định và hệ số hằng khi xét tốc độ tăng dài hạn. Một hàm làm 3n + 12 thao tác đơn giản và một hàm làm n thao tác đều là O(n). Hàm đầu vẫn có thể chạy chậm hơn rõ rệt. Phân tích tiệm cận không xóa các hệ số hằng khỏi sản phẩm thực tế.
Với tìm kiếm tuyến tính ở trên, Θ(n) là phát biểu chặt hơn cho trường hợp xấu nhất: số phép so sánh có cả cận trên lẫn cận dưới tỷ lệ với n. Nói O(n²) cũng là một cận trên đúng, nhưng che mất việc hàm tăng chậm hơn bậc hai. Khi trao đổi hằng ngày, người ta thường dùng Big O để nói đến tốc độ tăng chặt. Hiểu định nghĩa giúp bạn nhận ra lời khẳng định thực sự đang được đưa ra.
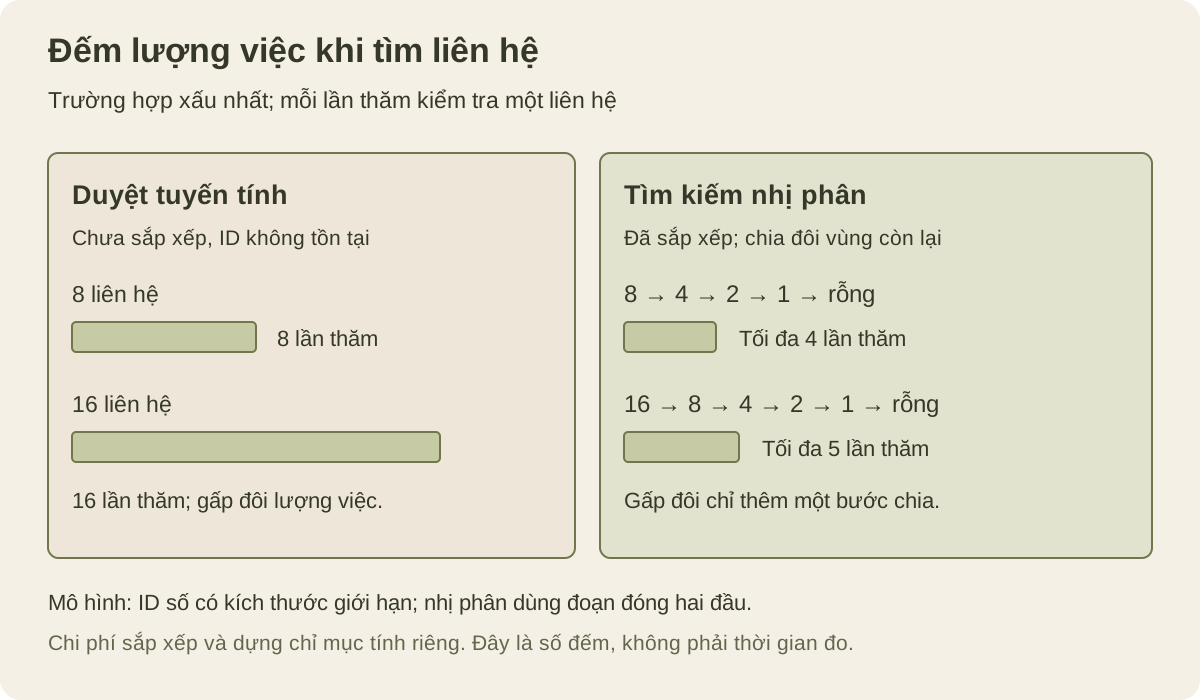
Hình dùng mô hình đơn giản: mỗi lần kiểm tra xét một liên hệ. Tìm kiếm nhị phân thực tế có thể thực hiện nhiều hơn một phép so sánh cơ bản trong lần kiểm tra đó. Khác biệt này thay đổi hệ số hằng, còn quy luật thu hẹp vùng tìm kiếm vẫn giữ nguyên.
Danh sách đã sắp xếp giúp bỏ bớt ứng viên
Nếu liên hệ được sắp theo ID số, tìm kiếm nhị phân có thể xét phần tử giữa rồi loại bỏ một nửa vùng còn lại. Sau một lần, còn khoảng n/2 ứng viên. Sau hai lần, còn khoảng n/4. Sau k lần, vùng tìm kiếm còn khoảng n/2ᵏ phần tử.
Kích thước vùng giảm xuống một hằng số khi 2ᵏ xấp xỉ n, nên k xấp xỉ log₂ n. Vì vậy, tìm kiếm nhị phân có thời gian xấu nhất O(log n). Với 1.000 phần tử, cách cài đặt dùng hai đầu mút đều được tính vào vùng tìm kiếm cần tối đa 10 lần xét phần tử giữa. Tăng lên 2.000 phần tử đưa cận này lên 11.
Điều kiện là dữ liệu đã được sắp theo đúng khóa và đúng thứ tự mà hàm tìm kiếm sử dụng. Sắp một mảng tùy ý chỉ để tìm một lần có thể tốn hơn quét mảng một lần. Nếu có nhiều truy vấn và danh sách ít thay đổi, sắp trước rồi tìm nhiều lần lại là một bài toán đánh đổi khác.
Khóa sắp xếp cũng phải phù hợp với truy vấn. Mảng sắp theo ID không trực tiếp giúp trả lời yêu cầu tìm những liên hệ có từ architect trong ghi chú. Điều kiện đó không liên quan đến thứ tự ID. Cần xác định thao tác muốn hỗ trợ trước khi chọn thuật toán.
Ví dụ sau đếm số lần xét phần tử giữa. Hàm có thể trả về bất kỳ phần tử khớp nào; dữ liệu minh họa giả định ID không trùng nhau.
function findSortedContact(contacts, wantedId) {
  let left = 0, right = contacts.length - 1, probes = 0;
  while (left <= right) {
    const middle = left + Math.floor((right - left) / 2);
    const contact = contacts[middle];
    probes += 1;
    if (contact.id === wantedId) return { contact, probes };
    if (contact.id < wantedId) left = middle + 1;
    else right = middle - 1;
  }
  return { contact: null, probes };
}

console.assert(findSortedContact(contacts, 999).probes === 10);
console.assert(findSortedContact(contacts, 1000).probes === 10);
console.assert(findSortedContact([], 1).probes === 0);
Nhờ thứ tự đã sắp, mỗi lần kiểm tra không khớp có thể loại phần tử giữa cùng một phía của nó. Với mảng chưa sắp, bước loại bỏ không có cơ sở và hàm có thể bỏ sót ID đang tồn tại. Kiểm tra toàn bộ thứ tự trước mỗi truy vấn lại tốn O(n). Nên kiểm tra hoặc duy trì điều kiện này khi danh sách thay đổi.
Chỉ mục chuyển một phần công việc về trước
Bảng băm cho phép xây dựng ánh xạ từ ID đến liên hệ rồi truy vấn ánh xạ đó. Với các giả định băm phù hợp, mỗi truy vấn có thời gian kỳ vọng O(1), còn việc dựng bảng có thời gian kỳ vọng O(n). Phần bảng băm nối chuỗi của Open Data Structures trình bày các giả định đó. Bảng cũng cần thêm bộ nhớ. Mô hình giả định hàm băm phân bố khóa đủ đều và số mục trung bình trong mỗi ngăn được giữ ở mức giới hạn. Các khóa băm trùng vẫn phải được phân biệt. Nếu nhiều khóa dồn vào một ngăn, truy vấn có thể phải duyệt một chuỗi dài. Kỳ vọng O(1) không bảo đảm mọi truy vấn riêng lẻ đều nhanh như nhau.
Trong JavaScript, Map thuận tiện cho cách dùng này:
const byId = new Map(contacts.map(contact => [contact.id, contact]));
const result = byId.get(999);
Không nên từ ví dụ suy ra rằng ngôn ngữ bảo đảm mọi Map.get đều có thời gian xấu nhất O(1). Đặc tả JavaScript yêu cầu thời gian truy cập trung bình tăng dưới tuyến tính theo số phần tử. Một môi trường thực thi có thể dùng những cấu trúc khác nhau để đáp ứng điều kiện ấy. Kết luận kỳ vọng O(1) thuộc về mô hình bảng băm với giả định đã nêu.
Nếu ID trùng, phần tử xuất hiện sau sẽ thay thế giá trị trước trong cách dựng Map này. Thêm hoặc xóa liên hệ cũng đòi hỏi cập nhật chỉ mục. Dựng lại toàn bộ bảng trong mỗi lần render phải duyệt lại cả n liên hệ chỉ để tránh một lần quét O(n). Vòng đời của chỉ mục phải phù hợp với cách ứng dụng sử dụng dữ liệu.
Tính cả vòng đời của chỉ mục
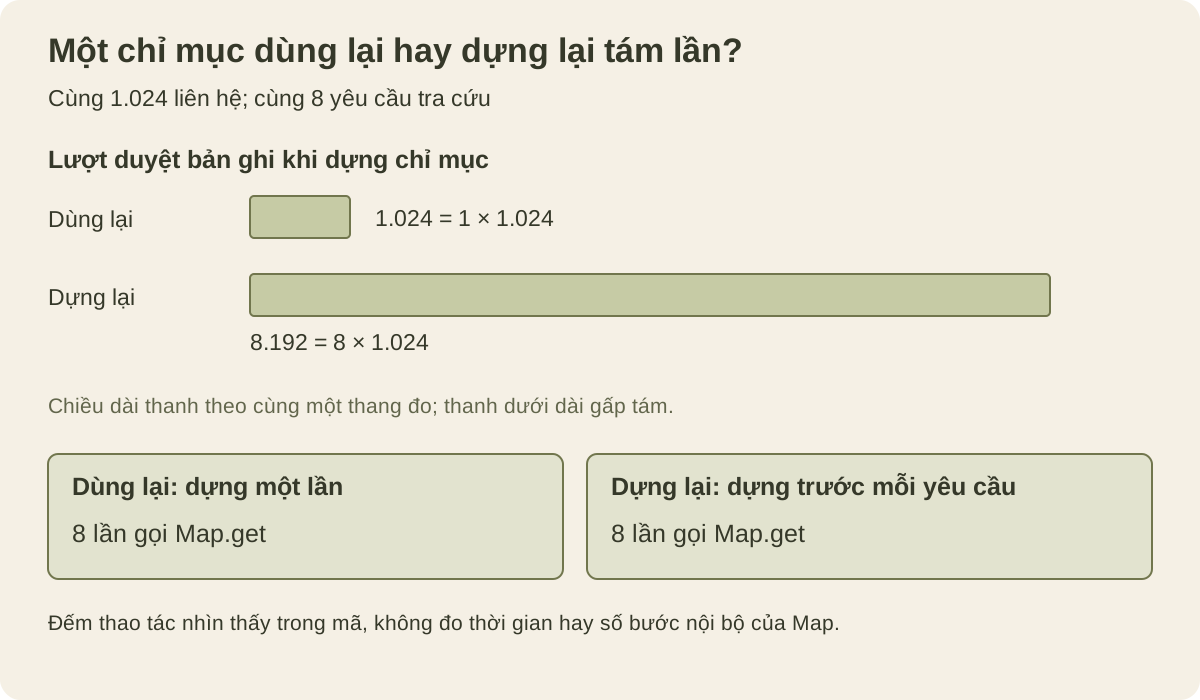
Giả sử một bản dữ liệu cố định có 1.024 liên hệ và phục vụ tám truy vấn. Dựng chỉ mục một lần duyệt qua 1.024 bản ghi. Dựng lại trước từng truy vấn duyệt qua tổng cộng 8.192 bản ghi. Cả hai cách đều gọi get tám lần. Đây là số hành động quan sát được trong chương trình, không phải phép đo thời gian hay số thao tác bên trong Map.
function buildContactIndex(snapshot) {
  const index = new Map();
  let recordsVisited = 0;
  for (const contact of snapshot) {
    recordsVisited += 1;
    index.set(contact.id, contact);
  }
  return { index, recordsVisited };
}

const snapshot = Array.from({ length: 1024 }, (_, id) => ({ id }));
const queryIds = [0, 1, 7, 31, 255, 511, 999, 1023];
const shared = buildContactIndex(snapshot);
for (const id of queryIds) shared.index.get(id);
let rebuiltVisits = 0;
for (const id of queryIds) {
  const rebuilt = buildContactIndex(snapshot);
  rebuiltVisits += rebuilt.recordsVisited;
  rebuilt.index.get(id);
}
console.assert(shared.recordsVisited === 1024);
console.assert(rebuiltVisits === 8192);
Trong mô hình bảng băm có truy vấn kỳ vọng hằng số, dựng một lần rồi thực hiện q truy vấn tốn kỳ vọng O(n + q). Dựng lại mỗi lần tốn kỳ vọng O(qn + q). Môi trường JavaScript thực tế vẫn tuân theo yêu cầu truy cập rộng hơn trong đặc tả. Cần phân biệt phân tích cấu trúc dữ liệu trừu tượng với bảo đảm của ngôn ngữ.
Dùng lại chỉ mục kéo theo trách nhiệm giữ nó đúng với dữ liệu. Nếu ID của một đối tượng liên hệ thay đổi, việc sửa đối tượng không tự chuyển mục tương ứng sang khóa mới trong Map. Một liên hệ đã xóa vẫn có thể còn được tìm thấy qua chỉ mục cũ. Bạn có thể cập nhật danh sách và chỉ mục cùng nhau, hoặc dựng lại khi nhận một bản dữ liệu mới. Tần suất thay đổi so với tần suất truy vấn giúp quyết định cách nào đơn giản hơn.
Chỉ mục cần bộ nhớ cho các mục của nó. Nó có thể giữ tham chiếu đến đối tượng liên hệ đang có thay vì sao chép đối tượng. Khi đó, các thay đổi nội dung đối tượng về sau cũng được nhìn thấy qua bảng. Quyền sở hữu trạng thái và hiệu năng cần được thiết kế cùng nhau; độ phức tạp của một truy vấn riêng lẻ chưa giải quyết cả hai vấn đề.
Thử nghiệm có thể tự tái hiện
Chạy hàm quét tuần tự với mảng có 8, 16, 32 và 64 liên hệ. Ở mỗi kích thước, tìm ID đầu tiên, cuối cùng và một ID không tồn tại. Ghi dự đoán trước khi chạy. Sau đó thay bằng tìm kiếm nhị phân trên các ID số đã sắp và đếm số lần xét phần tử giữa.
Giữ nhất quán định nghĩa một thao tác khi so sánh. Nếu một cột đếm vòng lặp còn cột kia đếm mọi phép so sánh cơ bản, hãy ghi rõ chúng là hai đơn vị khác nhau. Cả hai có thể hữu ích, nhưng trả lời hai câu hỏi khác nhau.
Sau khi số đếm khớp dự đoán, bạn có thể đo thời gian qua nhiều lần chạy. Với mảng nhỏ, quét tuyến tính có thể cạnh tranh vì mã đơn giản và đọc các vị trí kề nhau. Kết quả đó không phủ định phân tích tiệm cận. Nó cho thấy kích thước đang thử, cách cài đặt và máy đo chưa khiến tốc độ tăng trở thành yếu tố duy nhất đáng kể.
Một bộ chọn có vài chục liên hệ có thể chỉ cần quét. Danh bạ lớn được truy vấn liên tục cần xem xét cách đánh chỉ mục. Hãy ghi lại kích thước đầu vào, kiểu truy vấn và tần suất cập nhật trước khi chọn phương án.